Tag: GPU

  • Radeon RX 9060 XT Lampaui RTX 4090 dengan Overclocking

    Radeon RX 9060 XT Lampaui RTX 4090 dengan Overclocking

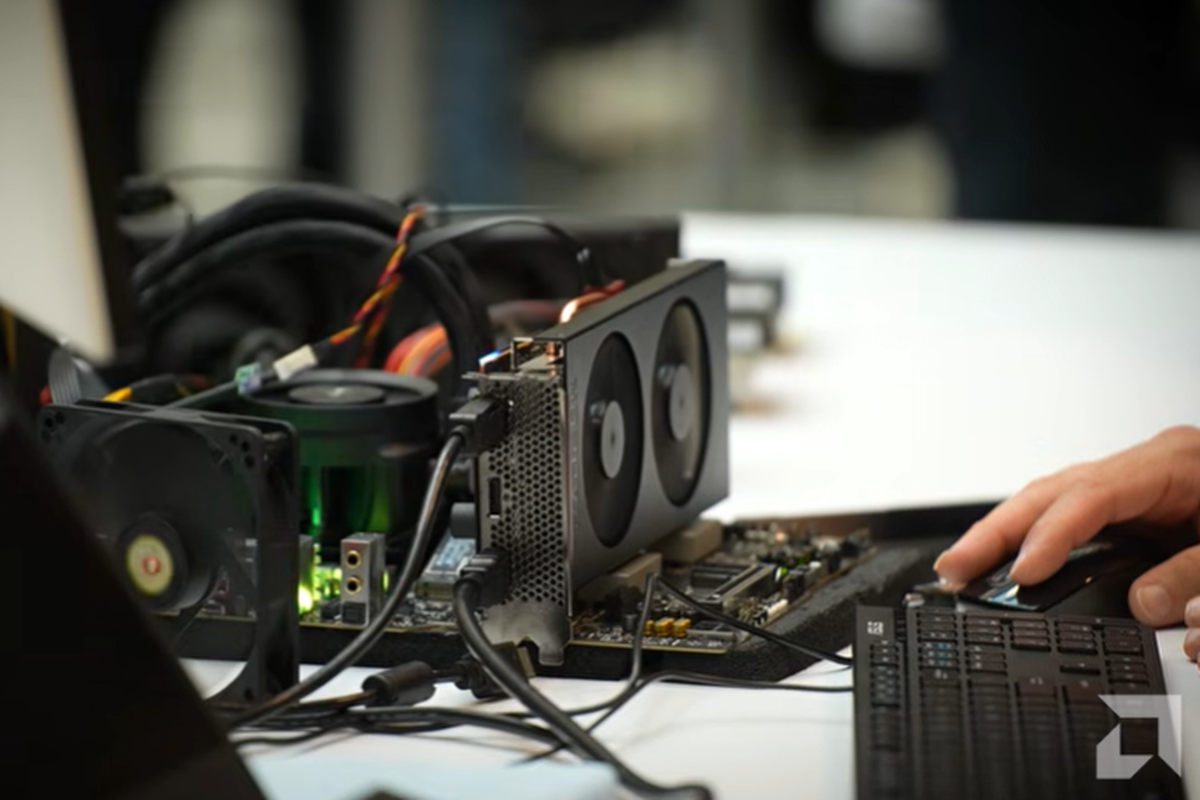
    Kartu pengolah grafis (GPU) kelas menengah AMD, Radeon RX 9060 XT, menunjukkan performa yang melampaui GPU kelas atas Nvidia GeForce RTX 4090.

    Kesimpulan ini didapatkan setelah Bill Alverson (Sampson) dan Allen Golibersuch (Splave), dua ahli GPU dari AS, berupaya meningkatkan performa RX 9060 XT melalui overclock.

    Uji coba yang berlangsung di kantor AMD, Ontario, Kanada, berhasil memacu GPU Radeon RX 9060 XT hingga 4.769 MHz (4,77 GHz).

    Sebagai perbandingan, RX 9060 XT standar memiliki base clock 1.700 MHz, game clock 2.530 MHz, dan boost clock maksimum 3.130 MHz.

    Dengan demikian, frekuensi 4,77 GHz yang dicapai Sampson dan Splave sekitar 52 persen lebih tinggi dari kecepatan boost clock resminya.

    Kecepatan GPU ini melampaui rekor dunia sebelumnya yang dipegang Nvidia GeForce RTX 4090.

    Berdasarkan data SkatterBench, GPU diskret tersebut sebelumnya di-overclock oleh Splave dan mencapai kecepatan clock 4.020 MHz (4 GHz), 700 MHz lebih rendah dari RX 9060 XT.

    Dalam prosesnya, AMD Radeon RX 9060 XT didinginkan menggunakan nitrogen cair (LN2).

    Sampson dan Splave tidak memberikan detail konfigurasi teknis GPU dan alat yang digunakan dalam upaya overclocking yang memecahkan rekor ini.

    Video yang dirilis AMD juga tidak memperlihatkan pengaturan voltase, suhu operasional, varian memori GPU (8 GB atau 16 GB), maupun pengujian benchmark yang digunakan untuk memvalidasi frekuensi puncak tersebut.

    Awalnya, GPU RX 9060 XT diuji dengan pendingin udara (air cooling) untuk menentukan batas awal overclock.

    Selanjutnya, Sampson dan Splave menggunakan pendingin nitrogen cair (liquid nitrogen/LN2) untuk mencapai frekuensi ekstrem. LN2 membantu menjaga suhu GPU tetap rendah dan stabil, mencegah overheat saat dipacu dalam kondisi ekstrem.

    Splave sempat memprediksi bahwa clock maksimal GPU akan berada di kisaran 4,4–4,5 GHz.

    Namun, chip GPU tersebut ternyata memiliki headroom lebih besar dari perkiraan, sehingga RX 9060 XT mampu menembus angka 4.769 MHz.

    Angka ini juga melampaui rekor dunia kecepatan GPU terintegrasi Intel Graphics (Arrow Lake) yang di-overclock oleh Massman pada 9 Mei 2025 hingga 4.250 MHz.
  • Perkuat Infrastruktur AI, Meta Borong Jutaan Chip Generasi Terbaru Nvidia

    Perkuat Infrastruktur AI, Meta Borong Jutaan Chip Generasi Terbaru Nvidia

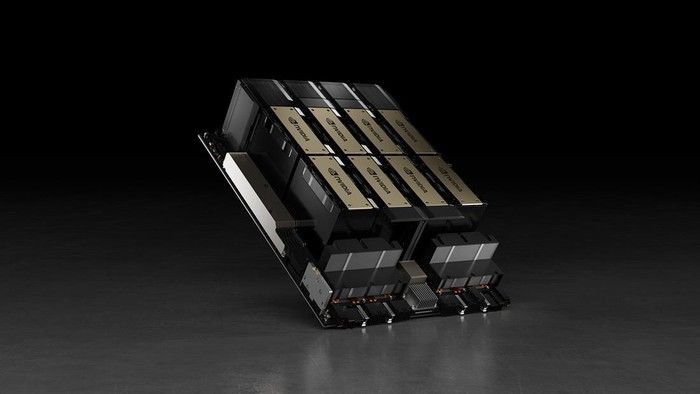
    Meta resmi menyepakati kerja sama strategis dengan Nvidia untuk melakukan ekspansi besar-besaran pada kapasitas data center miliknya. Dalam kesepakatan ini, perusahaan induk Facebook tersebut akan mengakuisisi jutaan unit CPU dan GPU generasi terbaru, termasuk kombinasi kartu grafis Blackwell dan Rubin, serta prosesor Grace dan Vera.

    Nvidia mengungkapkan bahwa proyek ini merupakan implementasi skala besar pertama untuk penggunaan CPU Grace-only. Teknologi tersebut diklaim mampu memberikan lompatan efisiensi performa per watt yang signifikan bagi infrastruktur komputasi Meta. Langkah ini menjadi bagian dari roadmap jangka panjang Meta yang juga berencana mengintegrasikan CPU Vera pada tahun 2027 mendatang.

    Meskipun volume pembelian hardware dari Nvidia meningkat tajam, Meta sebenarnya tengah berupaya mengembangkan chip AI secara mandiri untuk mengurangi ketergantungan pada vendor eksternal. Namun, laporan dari Financial Times mengindikasikan bahwa ambisi chip internal Meta masih terganjal kendala teknis dan penundaan jadwal peluncuran.

    Ketergantungan industri terhadap Nvidia tetap tinggi di tengah persaingan ketat. CNBC mencatat posisi pasar Nvidia sempat fluktuatif, termasuk penurunan saham sebesar 4% pada November lalu setelah muncul kabar Meta mempertimbangkan penggunaan chip Tensor milik Google. Di saat yang sama, kompetitor lain seperti AMD juga mulai melakukan penetrasi pasar melalui kolaborasi dengan OpenAI dan Oracle.

    Investasi Masif Melampaui Program Luar Angkasa

    Besarnya skala kebutuhan komputasi untuk melatih model AI tercermin dari anggaran belanja perusahaan teknologi raksasa saat ini. Meski nilai kontrak antara Meta dan Nvidia tidak dipublikasikan, total belanja AI tahun ini dari Meta, Microsoft, Google, dan Amazon diproyeksikan sangat fantastis.

    Estimasi total belanja empat raksasa teknologi tersebut diperkirakan melampaui biaya keseluruhan program Apollo, proyek pendaratan manusia di bulan yang menjadi program luar angkasa terbesar dalam sejarah Amerika Serikat. Hal ini menegaskan betapa krusialnya penguasaan infrastruktur hardware dalam perlombaan teknologi kecerdasan buatan global.

  • Nvidia Perkenalkan Teknik DMS, Pangkas Penggunaan Memori GPU AI Hingga 8 Kali Lipat

    Nvidia Perkenalkan Teknik DMS, Pangkas Penggunaan Memori GPU AI Hingga 8 Kali Lipat

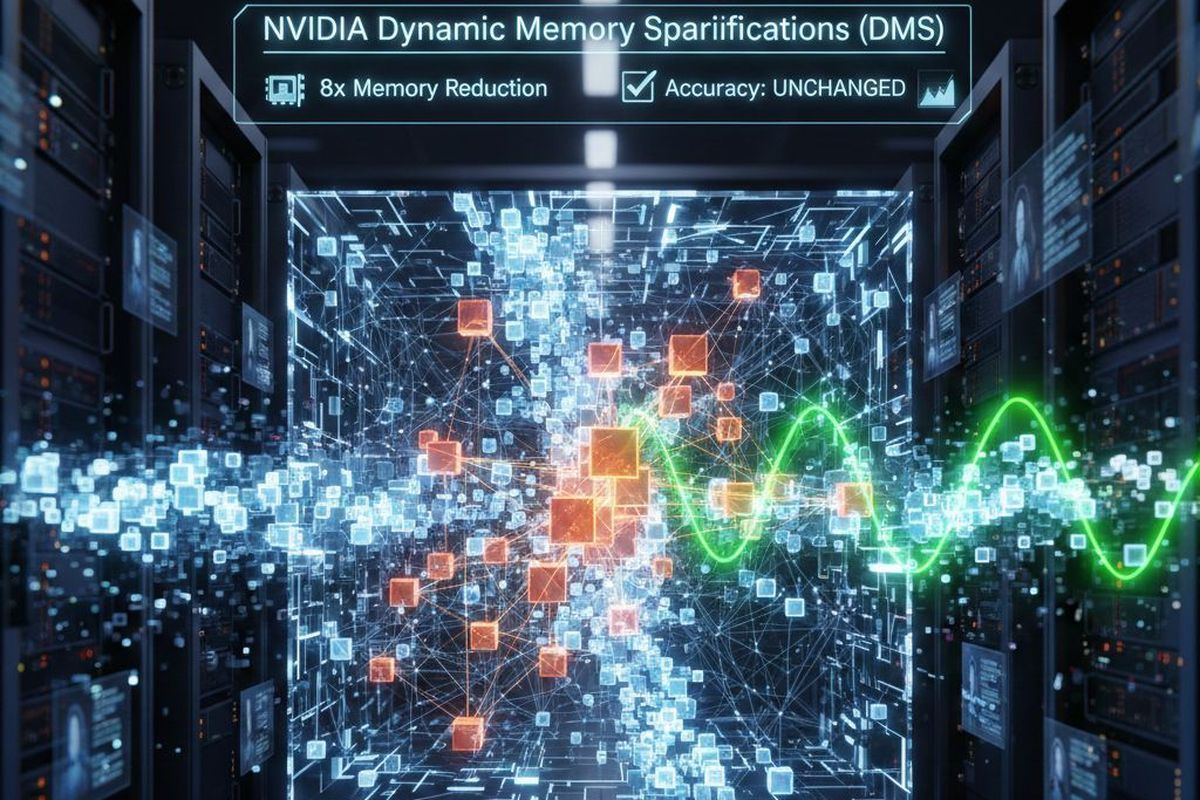
    Nvidia meluncurkan inovasi terbaru bertajuk Dynamic Memory Sparsification (DMS), sebuah teknik yang diklaim mampu mereduksi kebutuhan memori komputasi kecerdasan buatan (AI) hingga delapan kali lipat. Teknologi ini dirancang khusus untuk mengatasi lonjakan beban pada GPU saat model bahasa besar (LLM) menjalankan proses penalaran atau reasoning.

    Hambatan utama dalam pengembangan sistem AI skala besar saat ini terletak pada pertumbuhan key-value cache (KV cache). Memori sementara ini terus membengkak seiring bertambahnya token yang dihasilkan selama proses berpikir model, yang pada akhirnya memicu biaya komputasi tinggi dan membatasi kapasitas layanan pengguna. Lewat DMS, Nvidia menawarkan solusi agar sistem tetap efisien meskipun menangani konteks yang panjang.

    Berbeda dengan metode konvensional yang menggunakan aturan tetap (heuristik) untuk menghapus memori lama, DMS memungkinkan model untuk secara cerdas mengelola memorinya sendiri. Sistem ini melatih model untuk memilah mana token yang relevan bagi proses penalaran selanjutnya dan mana yang bisa dihapus tanpa mendegradasi kualitas output.

    Nvidia juga menyematkan fitur delayed eviction untuk memperkuat akurasi. Mekanisme ini menunda penghapusan token agar model memiliki waktu lebih banyak untuk menyerap konteks penting sebelum data dibersihkan dari memori. Berdasarkan pengujian pada model populer seperti Llama dan Qwen, penerapan DMS justru meningkatkan skor pada benchmark matematika dan pengkodean dibandingkan versi standar.

    Dampak Operasional dan Implementasi

    Implementasi efisiensi memori ini berdampak langsung pada performa perangkat keras. Dengan cache yang lebih ringkas, GPU tidak perlu melakukan aktivitas baca-tulis data dalam volume masif secara terus-menerus. Hasilnya, latensi berkurang secara signifikan, throughput meningkat, dan risiko kehabisan memori (out-of-memory) dapat dihindari.

    Kabar baik bagi pengembang, Nvidia menyatakan bahwa DMS dapat diterapkan langsung pada model yang sudah dilatih (pre-trained) tanpa perlu melakukan pelatihan ulang dari nol. Teknologi ini telah diintegrasikan ke dalam framework Model Optimizer Nvidia dan sepenuhnya kompatibel dengan infrastruktur standar seperti FlashAttention serta ekosistem Hugging Face.